
Распознавание рукописных цифр
Распознавание рукописных цифр
Категория проекта: Классификация объектов
Пошаговое описание создания проекта Распознавание рукописных цифр!
Страница Web-приложения DigitalRecognitionWeb
Будем обучать модель нейронной сети в Colaboratory на базе mnist, где 60000 изображений рукописных цифр. Каждое изображение представлено в сером цвете, размер изображения 28x28 пикселей.
Импортируем необходимые библиотеки.
import numpy as np
from tensorflow import keras
from tensorflow.keras.models import Model
from tensorflow.keras.layers import Input, Conv2D, MaxPooling2D, Flatten, Dropout, Dense
from tensorflow.keras.callbacks import ReduceLROnPlateau
from tensorflow.keras.optimizers import Adam
После обучения модели сохраним её на Google диске. Для этого смонтируем его.
from google.colab import drive
drive.mount('/content/drive', force_remount=True)
Для создания каталогов определим вспомогательную функцию (наверно, вспомогательные функции я скоро перенесу в отдельную статью, чтобы не дублировать одно и тоже несколько раз).
import os
import shutil

def create_dir_if_not_exists(src_dir, echo=False):
  """Создание директории если она не существует

  Parameters
  ----------
    src_dir: str
      Директория для создания

    echo: bool (default=False)
      Флаг вывода сообщения
  """
  # проверяем отсутствует ли директория src_dir
  if not os.path.exists(src_dir):
    # Создаём директорию src_dir
    os.makedirs(src_dir)
    # Если флаг вывода сообщения установлен
    if echo:
      # Выводим сообщение
      print(f"Создана директория '{src_dir}'")
  # Если директория src_dir уже существует
  else:
    # Проверим флаг вывода сообщения, если он True
    if echo:
      # Выводим сообщение о том, что директория уже существует
      print(f"Директория '{src_dir}' уже существует")
И функцию вывода процесса обучения модели.
import matplotlib.pyplot as plt

def ShowHistory(h, metrics=["loss"]):
  """Отображение графиков обучения модели.

  Parameters
  ----------
    h: Объект History
      History.history содержит информацию об ошибках и метриках на этапах
      обучения модели.

    metrics: list (default=["loss"])
      Список ошибок и метрик.
  """
  # Для каждой метрики из списка
  for m in metrics:
    # Проверяем есть ли история
    if m in h.history:
      # Рисуем метрику на графике
      plt.plot(h.history[m], label='train')
      # Проверяем есть ли история для метрики на проверочном наборе
      if 'val_' + m in h.history:
        # Рисуем метрику на графике
        plt.plot(h.history['val_' + m], label='val')
      # Подписываем ось x
      plt.xlabel('Эпоха обучения')
      # Подписываем ось y
      plt.ylabel(m)
      # добавляем легенду
      plt.legend()
      # Отображаем график
      plt.show()
Загрузим данные mnist. num_classes - это число классов для распознавания (цифры от 0 до 9).
num_classes = 10
(x_train, y_train), (x_test, y_test) = keras.datasets.mnist.load_data()
Можно посмотреть как выглядит изображение цифры с индексом 13.
plt.imshow(x_train[13], 'gray')
plt.show()
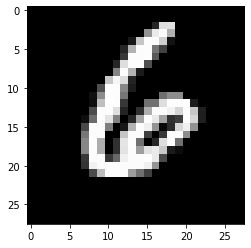
Сделаем нормирование и подготовим размерность данных необходимую для обучения модели с использованием свёртки.
x_train = x_train.astype("float32") / 255
x_test = x_test.astype("float32") / 255

x_train = np.expand_dims(x_train, -1)
x_test = np.expand_dims(x_test, -1)
Преобразуем данные выхода модели в формат OHE (One Hot Encoding) - это вектор из 10 элементов, где на значимой позиции установлена единица, остальные позиции установлены в ноль.
y_train = keras.utils.to_categorical(y_train, num_classes)
y_test = keras.utils.to_categorical(y_test, num_classes)
Напишем функцию создания модели.
def create_model(input_shape, num_classes):
  inp = Input(shape=input_shape)

  x = Conv2D(32, kernel_size=(3, 3),  padding='same', activation="relu")(inp)
  x = MaxPooling2D(pool_size=(2, 2))(x)
  x = Conv2D(64, kernel_size=(3, 3),  padding='same', activation="relu")(x)
  x = MaxPooling2D(pool_size=(2, 2))(x)
  x = Flatten()(x)
  x = Dropout(0.5)(x)
  x = Dense(num_classes, activation="softmax")(x)
  model = Model(inp, x)

  model.summary()
  model.compile(loss="categorical_crossentropy", optimizer=Adam(learning_rate=0.01), metrics=["accuracy"])

  return model
Структура модели состоит из 2х свёрточных слоев и одного полносвязного слоя на выходе модели. Также используется слой Dropout, который позволяет бороться с переобучением модели. Слой Flatten переводит размерность данных из двухмерной в одномерную. Ядро свертки в свёрточных слоях используем 3x3, а функцию активации relu. На последнем слое функция активации softmax. Функция ошибки обучения модели categorical_crossentropy, Оптимизатор Adam. также будем наблюдать за метрикой accuracy (точность).
Создаём модель.
model = create_model((28, 28, 1), num_classes)
Вот структура, которая была описана выше.
Model: "functional_7"
_________________________________________________________________
Layer (type)                 Output Shape              Param #
=================================================================
input_4 (InputLayer)         [(None, 28, 28, 1)]       0
_________________________________________________________________
conv2d_6 (Conv2D)            (None, 28, 28, 32)        320
_________________________________________________________________
max_pooling2d_6 (MaxPooling2 (None, 14, 14, 32)        0
_________________________________________________________________
conv2d_7 (Conv2D)            (None, 14, 14, 64)        18496
_________________________________________________________________
max_pooling2d_7 (MaxPooling2 (None, 7, 7, 64)          0
_________________________________________________________________
flatten_3 (Flatten)          (None, 3136)              0
_________________________________________________________________
dropout_3 (Dropout)          (None, 3136)              0
_________________________________________________________________
dense_3 (Dense)              (None, 10)                31370
=================================================================
Total params: 50,186
Trainable params: 50,186
Non-trainable params: 0
_________________________________________________________________
При обучении воспользуемся callback'ом ReduceLROnPlateau, который позволяет уменьшать скорость обучения модели, если на предыдущих эпохах значение, которое мы мониторим, не улучшается.
callback_RLR = ReduceLROnPlateau(monitor='val_accuracy',
                        factor=0.5,
                        patience=5,
                        verbose=1,
                        mode='auto',
                        min_delta=0.0001,
                        cooldown=0,
                        min_lr=0)
Установим пакет мини-выборки и запустим обучение. Обучать будем 30 эпох. Для проверочной выборки используем 10% от всей выборки.
batch_size = 128
history = model.fit(x_train, y_train, batch_size=batch_size, epochs=30, validation_split=0.1, callbacks=[callback_RLR])
Лог процесса обучения.
Epoch 1/30
422/422 [==============================] - 2s 5ms/step - loss: 0.1731 - accuracy: 0.9462 - val_loss: 0.0566 - val_accuracy: 0.9837
Epoch 2/30
422/422 [==============================] - 2s 5ms/step - loss: 0.0855 - accuracy: 0.9730 - val_loss: 0.0411 - val_accuracy: 0.9895
Epoch 3/30
422/422 [==============================] - 2s 5ms/step - loss: 0.0735 - accuracy: 0.9776 - val_loss: 0.0413 - val_accuracy: 0.9887
Epoch 4/30
422/422 [==============================] - 2s 5ms/step - loss: 0.0661 - accuracy: 0.9803 - val_loss: 0.0375 - val_accuracy: 0.9900
Epoch 5/30
422/422 [==============================] - 2s 5ms/step - loss: 0.0621 - accuracy: 0.9806 - val_loss: 0.0417 - val_accuracy: 0.9897
Epoch 6/30
422/422 [==============================] - 2s 5ms/step - loss: 0.0584 - accuracy: 0.9818 - val_loss: 0.0425 - val_accuracy: 0.9880
Epoch 7/30
422/422 [==============================] - 2s 5ms/step - loss: 0.0571 - accuracy: 0.9824 - val_loss: 0.0408 - val_accuracy: 0.9895
Epoch 8/30
422/422 [==============================] - 2s 5ms/step - loss: 0.0558 - accuracy: 0.9831 - val_loss: 0.0336 - val_accuracy: 0.9912
Epoch 9/30
422/422 [==============================] - 2s 5ms/step - loss: 0.0568 - accuracy: 0.9825 - val_loss: 0.0477 - val_accuracy: 0.9897
Epoch 10/30
422/422 [==============================] - 2s 5ms/step - loss: 0.0560 - accuracy: 0.9837 - val_loss: 0.0376 - val_accuracy: 0.9903
Epoch 11/30
422/422 [==============================] - 2s 5ms/step - loss: 0.0568 - accuracy: 0.9830 - val_loss: 0.0328 - val_accuracy: 0.9915
Epoch 12/30
422/422 [==============================] - 2s 5ms/step - loss: 0.0546 - accuracy: 0.9841 - val_loss: 0.0403 - val_accuracy: 0.9902
Epoch 13/30
422/422 [==============================] - 2s 5ms/step - loss: 0.0543 - accuracy: 0.9839 - val_loss: 0.0364 - val_accuracy: 0.9908
Epoch 14/30
422/422 [==============================] - 2s 5ms/step - loss: 0.0565 - accuracy: 0.9837 - val_loss: 0.0415 - val_accuracy: 0.9902
Epoch 15/30
422/422 [==============================] - 2s 5ms/step - loss: 0.0584 - accuracy: 0.9840 - val_loss: 0.0383 - val_accuracy: 0.9907
Epoch 16/30
421/422 [============================>.] - ETA: 0s - loss: 0.0597 - accuracy: 0.9834
Epoch 00016: ReduceLROnPlateau reducing learning rate to 0.004999999888241291.
422/422 [==============================] - 2s 5ms/step - loss: 0.0597 - accuracy: 0.9834 - val_loss: 0.0463 - val_accuracy: 0.9898
Epoch 17/30
422/422 [==============================] - 2s 5ms/step - loss: 0.0375 - accuracy: 0.9893 - val_loss: 0.0371 - val_accuracy: 0.9923
Epoch 18/30
422/422 [==============================] - 2s 5ms/step - loss: 0.0319 - accuracy: 0.9901 - val_loss: 0.0355 - val_accuracy: 0.9927
Epoch 19/30
422/422 [==============================] - 2s 5ms/step - loss: 0.0303 - accuracy: 0.9906 - val_loss: 0.0376 - val_accuracy: 0.9932
Epoch 20/30
422/422 [==============================] - 2s 5ms/step - loss: 0.0290 - accuracy: 0.9906 - val_loss: 0.0393 - val_accuracy: 0.9920
Epoch 21/30
422/422 [==============================] - 2s 5ms/step - loss: 0.0257 - accuracy: 0.9918 - val_loss: 0.0381 - val_accuracy: 0.9927
Epoch 22/30
422/422 [==============================] - 2s 5ms/step - loss: 0.0290 - accuracy: 0.9912 - val_loss: 0.0369 - val_accuracy: 0.9925
Epoch 23/30
422/422 [==============================] - 2s 5ms/step - loss: 0.0258 - accuracy: 0.9920 - val_loss: 0.0440 - val_accuracy: 0.9917
Epoch 24/30
411/422 [============================>.] - ETA: 0s - loss: 0.0260 - accuracy: 0.9922
Epoch 00024: ReduceLROnPlateau reducing learning rate to 0.0024999999441206455.
422/422 [==============================] - 2s 5ms/step - loss: 0.0263 - accuracy: 0.9921 - val_loss: 0.0315 - val_accuracy: 0.9932
Epoch 25/30
422/422 [==============================] - 2s 5ms/step - loss: 0.0189 - accuracy: 0.9938 - val_loss: 0.0374 - val_accuracy: 0.9933
Epoch 26/30
422/422 [==============================] - 2s 5ms/step - loss: 0.0185 - accuracy: 0.9940 - val_loss: 0.0412 - val_accuracy: 0.9928
Epoch 27/30
422/422 [==============================] - 2s 5ms/step - loss: 0.0161 - accuracy: 0.9944 - val_loss: 0.0387 - val_accuracy: 0.9932
Epoch 28/30
422/422 [==============================] - 2s 5ms/step - loss: 0.0160 - accuracy: 0.9946 - val_loss: 0.0378 - val_accuracy: 0.9938
Epoch 29/30
422/422 [==============================] - 2s 5ms/step - loss: 0.0166 - accuracy: 0.9944 - val_loss: 0.0364 - val_accuracy: 0.9932
Epoch 30/30
422/422 [==============================] - 2s 5ms/step - loss: 0.0160 - accuracy: 0.9944 - val_loss: 0.0361 - val_accuracy: 0.9937
Выведем процесс обучения модели в графическом виде.
ShowHistory(history, metrics=['loss', 'accuracy'])

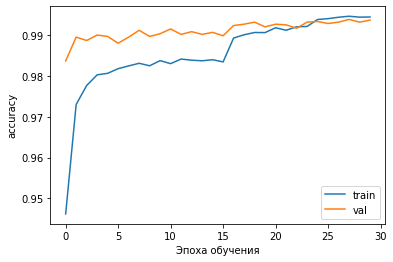
На графиках четко видны скачки в районе 15й эпохи, уменьшается ошибка и увеличивается точность распознавания, это происходит из-за уменьшения скорости обучения.
На данном этапе видно, что модель можно еще обучить несколько эпох, но не перестараться, чтобы не возникло переобучение.
По окончанию обучения создаем директорию на Google Диске для сохранения модели и сохраняем её.
model_dir = 'drive/My Drive/EvgenyKondratev.ru/digital_recognition/model'
create_dir_if_not_exists(model_dir)
model.save(os.path.join(model_dir, "digital_recognition_model.hdf5"))
Страница Web-приложения DigitalRecognitionWeb